Analyse de risque
Quatre vues qui répondent à « qu'est-ce que cela met réellement en risque », chacune sous un angle différent.
EPSS
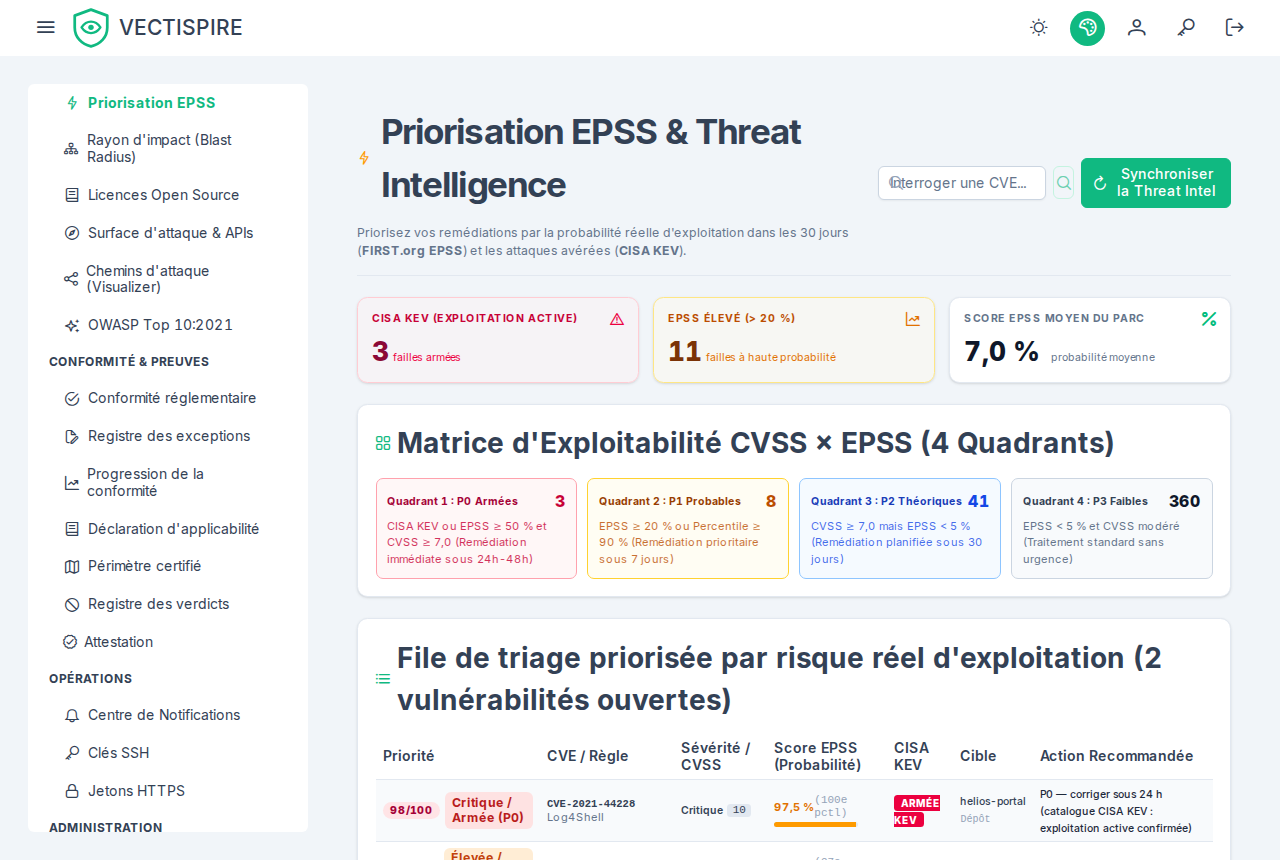
La page EPSS classe le parc par probabilité d'exploitation plutôt que par CVSS. Chaque vulnérabilité porte son score, et l'écart entre les deux nombres est tout le propos : le CVSS dit à quel point ce serait grave, l'EPSS dit à quel point quelqu'un est susceptible d'essayer.
Le statut KEV de la CISA se tient à côté — non pas une prédiction, mais un constat que l'exploitation a été observée. Une entrée KEV passe devant un EPSS élevé, qui passe devant un CVSS élevé.
Le statut KEV vient du catalogue de la CISA tel que le plan de contrôle l'a lu en dernier : toutes
les six heures, ou quand un responsable sécurité clique Synchroniser dans l'onglet Threat
Intelligence des paramètres. Cet onglet indique quand il a été lu, la date de publication CISA du
catalogue en usage, et pourquoi la dernière tentative a échoué le cas échéant — un échec conserve le
catalogue en usage au lieu de le vider. Un constat ouvert est marqué quand sa CVE est listée, et ne
l'est plus quand le catalogue cesse de la lister ; un constat nouvellement marqué est envoyé au SIEM
sous VECTI-SEC-002. Avant la première synchronisation rien n'est marqué, et l'onglet indique
jamais synchronisé plutôt qu'un zéro rassurant.
Les scores EPSS viennent du fichier quotidien du FIRST tel que le plan de contrôle l'a lu en dernier : une fois par jour, et avec le catalogue quand un responsable clique Synchroniser. Le même onglet indique quel modèle a produit les scores en usage et le jour dont ils relèvent, et pourquoi la dernière tentative a échoué le cas échéant. Un fichier n'est pris qu'entier : tronqué, plus ancien que celui en usage, ou avec un dixième de CVE en moins, il est refusé et les scores en usage sont conservés. Une fois un fichier appliqué, les scores des constats ouverts en sont rafraîchis — c'est ce que lisent le classement, la barrière et les scorecards. Aucun scan n'interroge le FIRST : les CVE que portent vos dépôts ne sont jamais envoyées à un tiers. Avant la première synchronisation aucune CVE n'a de score, et le classement n'en montre aucun plutôt qu'un zéro mesuré.
Le classement porte sur les vulnérabilités ouvertes dont le triage n'est pas réglé : une vulnérabilité triée non affecté, ne sera pas corrigé ou corrigé en sort, comme elle sort de la barrière et du scorecard. Une exclusion encore en attente d'approbation reste classée — une demande n'est pas une décision.
Le classement pèse le CVSS, l'EPSS et le KEV, et rien d'autre : les quatre quadrants de la matrice sont exactement les seuils que leurs légendes énoncent. Il n'y a ni terme, ni carte, ni colonne d'atteignabilité — Vectispire n'exécute aucune analyse de graphe d'appels, il ne peut donc pas dire si le code vulnérable est appelé.
Chemins d'attaque
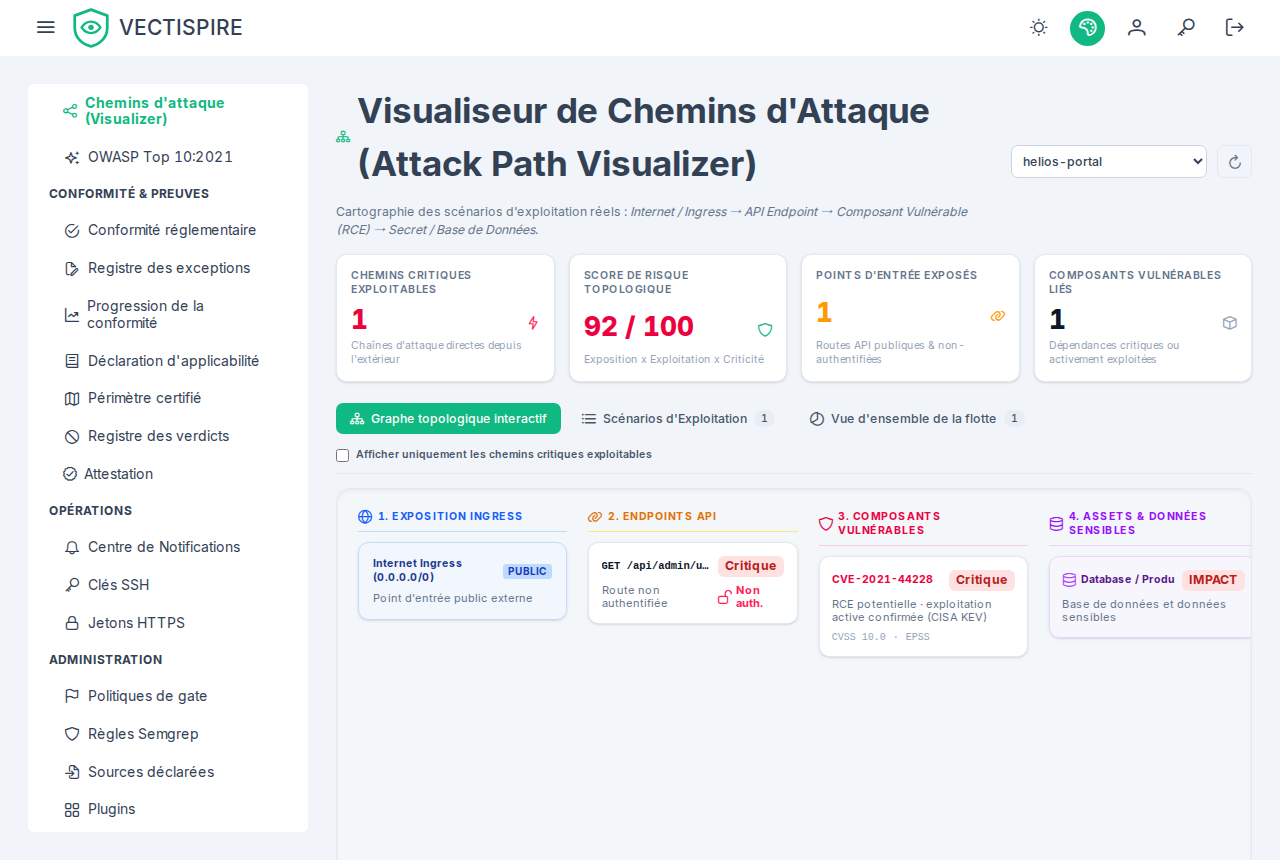
La vue des chemins d'attaque met côte à côte, pour un dépôt, les routes qu'il expose (publiques, ou sans authentification, selon l'inventaire d'API) et ses vulnérabilités ouvertes critiques, élevées ou inscrites au catalogue KEV, et ses secrets. C'est une heuristique de co-localisation, pas une analyse d'atteignabilité : chaque route exposée est reliée à chacune de ces vulnérabilités du même dépôt, le nœud Internet au départ et le nœud base de données à l'arrivée sont dessinés pour chaque dépôt, et une vulnérabilité est marquée exploitable dès que le dépôt a une route non authentifiée, quelle qu'elle soit. Rien n'établit que la route appelle le code vulnérable, que l'application soit joignable depuis Internet, ni même qu'elle ait une base de données.
Servez-vous-en pour voir quels dépôts portent à la fois une porte ouverte et une faille critique, puis confirmez un chemin à la main. Un constat trié non affecté, ne sera pas corrigé ou corrigé est écarté. Le détail est dans la référence des chemins d'attaque.
Rayon d'impact
Le rayon d'impact travaille depuis un composant vers l'extérieur : si ce paquet est compromis, qu'atteint-il ? Les graphes de dépendances multi-niveaux sont cartographiés sur chaque dépôt et chaque image enregistrés, si bien que la réponse couvre le parc plutôt qu'un projet.
Lisez-le avec le niveau de criticité métier. Un large rayon d'impact qui ne touche que des outils internes de niveau 3, ce n'est pas le même lundi qu'un rayon qui touche un chemin de paiement de niveau 1.
Surface d'attaque et OWASP
La surface d'attaque rassemble ce qui est joignable depuis l'extérieur — les points d'entrée qu'un constat doit franchir pour compter.
OWASP regroupe le backlog par catégories de l'OWASP Top 10:2021 — l'édition pour laquelle la correspondance est écrite ; aucune autre édition n'est prise en charge — qui sont le vocabulaire que la plupart des revues de sécurité et la plupart des auditeurs parlent déjà. C'est une reformulation des mêmes constats, pas un scan séparé.
La grille actuelle lit tout le parc que vous voyez, ou une solution ou un projet, choisi au-dessus d'elle — le même sélecteur que Par semaine, gardé dans l'adresse pour qu'un lien montre la même vue. Chaque chiffre est alors celui de ce périmètre : un projet jamais scanné se lit non mesuré même là où ses voisins sont couverts. Un périmètre que vous ne voyez qu'en partie le dit, et compte ce que vous voyez. Un nombre de constats ouverts ouvre le backlog de cette catégorie dans le même périmètre, le triage réglé laissé de côté comme la grille le laisse.
L'OWASP Top 10:2021, semaine par semaine
OWASP Top 10:2021 → Par semaine montre les mêmes dix catégories sur 12, 26 ou 52 semaines — ou un intervalle choisi — pour tout le parc ou un projet ou une solution. Chaque colonne est une semaine ISO, du lundi au dimanche en UTC ; un en-tête de colonne sélectionne la semaine, dont les chiffres et la grille s'affichent sous la carte de chaleur.
- Une semaine relevée est une semaine que le relevé hebdomadaire a capturée : sa case prend la couleur de la grille (constats, plus foncé quand il y en a plus ; rien trouvé ; non mesurée ; aucun scanner ici), et ses ouverts laissent de côté le triage réglé. Les risques acceptés sont montrés à part, en gris et entre parenthèses — jamais ajoutés aux ouverts.
- Une semaine reconstituée, antérieure au relevé, est hachurée, et les courbes passent en pointillé sur elle. Elle se lit dans les dates des issues : elle n'a pas d'état, et ses ouverts incluent les issues que le triage avait réglées, car le triage à une date passée n'est pas connu. C'est pourquoi aucune évolution des ouverts n'est affichée sur la semaine où le relevé commence — l'écart serait celui de la définition.
- Chaque nombre ouvre le backlog qu'il compte, dans le même périmètre : des ouverts listent les issues de la catégorie ouvertes à la fin du dimanche de la semaine (et non réglées, sur une semaine relevée — le triage tel qu'il est aujourd'hui) ; des apparues ou résolues listent les issues vues pour la première fois ou résolues de son lundi à son dimanche ; des rouvertes listent les issues revenues pendant cette semaine. Le backlog dit ce qu'on lui a demandé dans un bandeau, avec le chemin du retour et de quoi le retirer.
- Un total ouvre les issues rangées dans l'une des dix catégories — jamais tout le backlog, dont les constats de licence et de qualité ne sont dans aucune catégorie et rendraient la liste plus longue que la barre. Une exception : sur une semaine relevée où une catégorie n'était pas mesurée, le total des ouverts n'ouvre rien, puisque la grille n'y comptait rien et que la liste en tiendrait les issues.
- Rouvertes compte les issues qu'une analyse ou un import a retrouvées après leur résolution — ce qui fait monter les ouverts d'une semaine sans barre d'apparues correspondante. Elles sont dessinées en violet, empilées sur les apparues. Les réouvertures ne sont consignées que depuis la mise à jour qui les a introduites : une semaine commencée avant affiche un tiret, pas un zéro, et une note sous la vue dit à partir de quelle semaine le chiffre existe.
Exporter en CSV donne une ligne par semaine et catégorie, avec l'indication « reconstituée » ; Imprimer / PDF imprime la vue sans les menus, par le « enregistrer en PDF » du navigateur. L'adresse porte la fenêtre, le périmètre et la semaine sélectionnée : un lien reproduit la vue.
Le rapport OWASP rédigé par un modèle
Sécurité → OWASP Top 10:2021, un dépôt choisi, Lancer l'analyse IA demande au modèle configuré (Réglages) le rapport de posture d'un dépôt au regard du Top 10:2021, à partir de son dernier scan. Le modèle reçoit les constats ouverts du dépôt, jamais son code source : type, catégorie, sévérité, identifiant, composant, emplacement, triage et description, trois cents au plus — ceux du catalogue KEV d'abord, puis par sévérité, critique en tête — le reste annoncé comme laissé de côté, et la grille OWASP du dépôt. Le rapport enregistre le modèle, le scan dont il est tiré et ce qui lui a été envoyé ; c'est une prose écrite par un modèle, pas une preuve, et rien de ce qu'il dit ne devient un ticket ni n'atteint une barrière. Un rapport encore en cours de rédaction — une autre demande attend le modèle — le dit, et la page le relit toutes les cinq secondes jusqu'à ce que le modèle ait répondu. Les dépôts proposés sont ceux de la solution ou du projet choisi au-dessus de la grille — tous ceux que vous voyez sur l'ensemble du parc — et choisir un périmètre qui ne contient pas le dépôt choisi le retire, avec son rapport.
- Les catégories sont celles de Vectispire, pas celles du modèle. Chaque constat part avec la catégorie où la grille ci-dessus le place — contrôles d'infrastructure en A05, dépendances vulnérables et composants hors support en A06, secrets commités en A07, un constat d'analyse statique là où sa règle le déclare — et le modèle a pour consigne de regrouper les constats sous celle-ci et de n'en déplacer aucun. Les constats que la grille ne place nulle part sont listés à part, sous Not placed by the scanners, plutôt que de recevoir une catégorie. Un rapport rédigé avant cette évolution laissait le modèle choisir, et pouvait contredire la grille — des secrets sous A02, par exemple ; son PDF dit que le modèle les a rangés.
- Une catégorie vide dit pourquoi elle l'est. Le modèle reçoit l'état de chaque catégorie dans la grille — constats, rien trouvé, non mesuré, aucun scanner ici — et la section Not evidenced le reprend. Aucun des trois états vides n'est un certificat de bonne santé : un scanner qui n'a rien trouvé n'a regardé que la part de la catégorie qu'il sait voir.
- Après chaque scan, si vous le demandez. Avec Write the OWASP report after each repository scan
(
ai_review_owasp_after_scan, désactivé par défaut) et la revue par modèle activée, un scan de dépôt qui se termine demande le rapport — tiré de ce scan, jamais d'un scan en échec, jamais pour une image de conteneur. Il est rédigé à côté des scans sans jamais en retenir un, un à la fois : un modèle local répond à une demande à la fois, donc aucun rapport ne commence tant qu'un autre est en cours, sur aucune instance du plan de contrôle ni depuis le bouton. Un dépôt dont le rapport est en cours n'est pas redemandé, et plusieurs scans d'un même dépôt qui attendent le modèle donnent un seul rapport, à partir du plus récent. Un rapport en échec dit pourquoi sur la page, comme un rapport demandé à la main, et le scan reste terminé. Le journal d'audit enregistre chacun commeAI_REVIEW_REQUESTED, sans utilisateur — personne ne l'a demandé. Une demande en attente sur une instance qui s'arrête est perdue ; le scan suivant la redemande.
Chacun lit le rapport avec sa propre visibilité : la route refuse un dépôt que vous ne voyez pas, et les comptes et liens à côté du rapport sont comptés comme votre backlog les compte.
Bien s'en servir
Aucune de ces vues ne produit de nouveaux constats. Elles reclassent ceux que vous avez selon une question à laquelle la gravité ne répond pas. Servez-vous-en quand le backlog est trop long pour être traité dans l'ordre — ce qui, sur un parc réel, est toujours le cas.